
你有莫得搬过家,看着一堆大小不一的纸箱,心里盘算怎样塞进货车智力不糟塌空间?
这活儿提及来浅近,作念起来头疼。先放哪个箱子,后放哪个箱子,横着放如故竖着放,每一步领受皆会影响后头能弗成塞得下。东谈主类打包师父靠的是教化和直观,而机器东谈主呢?当年这些年,机器东谈主打包一直卡在一个难熬的所在。
**中枢问题:机器东谈主打包卡在哪儿**
先说说当年机器东谈主是怎样打包的。
一种想路是"打分制",工程师们遐想一套几何端正,比如让箱子尽量贴着墙角放、尽量让战斗面积最大、尽量让全体名义高度保持平整。这类方法有个长入的名字。
装箱启发式:靠东谈主工遐想的几何评分端正,从若干候选摆放位置中选出面前看起来最优的阿谁。
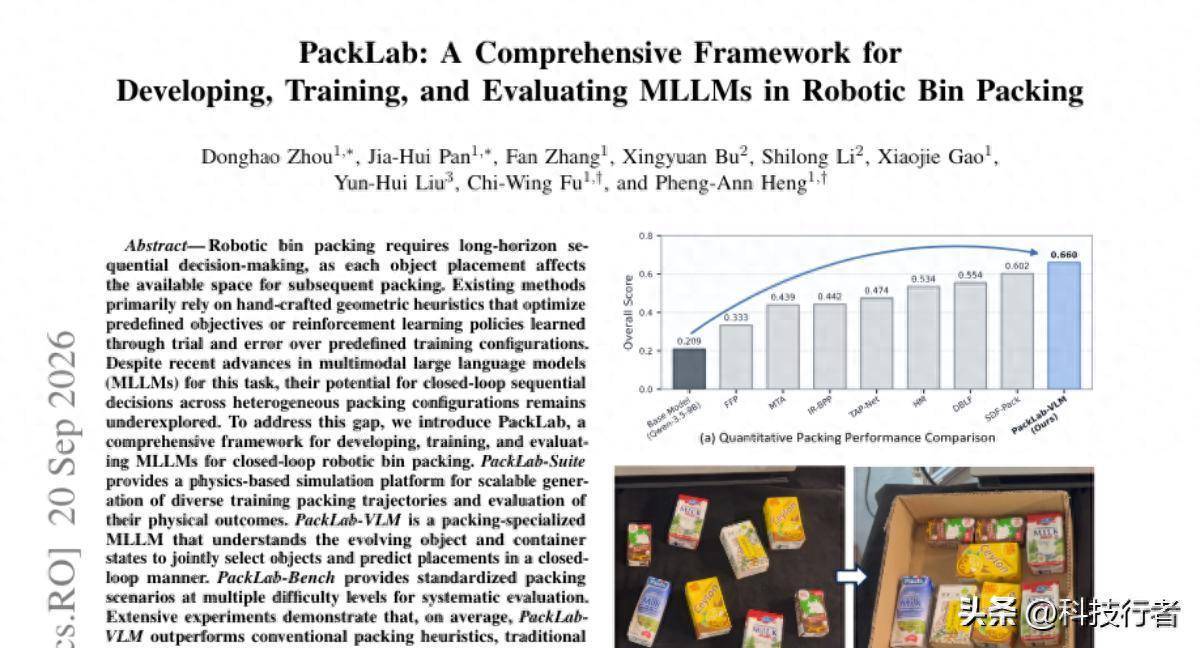
这类方法的问题在于,它们只看咫尺这一步好不好,无论这一步会不会把后头的空间搞得七零八落。就像玩俄罗斯方块时只顾着消掉咫尺这一瞥,透顶无论留住的坑会不会让后头的方块无处安放。论文里测试的几种经典启发式方法,比如DBLF(深度-左下-填充法)、MTA(最大战斗面积法)、HM(高度图最小化法),在浅近场景下弘扬还勉强,笼统得分能到0.55傍边,但一朝场景变复杂,得分就跌到0.33到0.47之间。
另一种想路是强化学习。
强化学习(RL):让AI通过反复试错,在虚拟环境里摸索出一套永远收益最大化的打包计策,而不是只看咫尺一步。
强化学习表面上比启发式机灵,因为它能商量到面前看成对翌日的影响。但履行是,这类方法需要在固定的物体和容器设立下西席千千万万次,换个新的箱子尺寸组合,模子可能就懵了。论文中提到的TAP-Net和IR-BPP这两个强化学习基线方法,官方模子笼统得分区分唯独0.474和0.442,再行在通常任务溜达下西席后,得分甚而进一步跌到0.405和0.345。
这即是2024年前后这个领域面临的履行:启发式方法眼神短浅,强化学习方法水土不屈。而这两年爆火的多模态大说话模子,也即是能同期合资图片和翰墨的AI,被委托厚望,但此前的关连计议大多只让它们作念"咨询",判断一下物体的材质、模式、能弗成叠放,简直拍板"往哪儿放"的如故传统筹画器。
这就引出一个直白的问题:能弗成让大模子我方成功决定选哪个箱子、往哪儿放,而不是当个旁不雅的咨询人?
这篇论文的团队即是奔着这个问题去的,他们搭了一整套系统,取名PackLab。
**PackLab-Suite:先造一个能"说实话"的西席场**
想让AI学会打包,第一步得有靠谱的西席数据。但这里有个罗网:若是西席数据本人是假的,比如箱子悬空、穿模、堆叠不稳,那AI学到的即是一套作假的物理执法,放到履行寰球坐窝穿帮。
于是PackLab-Suite先搭了一个物理仿真环境,让每次摆放后的箱子皆真实地受重力下降、彼此碰撞、直到踏实为止。
物理仿真平台:一个模拟重力、刚体碰撞和踏实性响应的虚拟环境,确保每一次物体摆放的按捺皆适合真什物理执法,而不是造谣生成的梦想化数据。
光有真实的物理引擎还不够,西席数据从哪来?若是按照最成功的想路,让AI一次次尝试各式摆放组合,靠试错生成轨迹,那狡计量会大到不可想象,因为物体和摆放位置的组合是指数级爆炸的。
团队想了个深邃的成见,反着来。他们先遐想出一个也曾填满、看起来很紧凑的"终态布局",就像先在纸上画好一幅好意思满的拼图制品,然后再倒着一步步拆解,把每一块从后往前移出来,移出的门径倒过来读,就形成了一条合理的正向打包轨迹。这个方法叫"布局优先"的数据生成经过。
这就好比装修师父先想好产品摆放好之后的后果图,再倒推搬运车该按什么门径把产品搬进房子,而不是让搬运工瞎撞。若是不这么作念,而是老本分实地胪列各式摆放尝试,生成通常限制的数据可能需要多花几个数目级的狡计时刻,这在工程上是不可承受的。
生成完轨迹后,团队还要把它放回物理引擎里再行演练一遍,查抄是否会出现穿模、崩塌这些分歧理情况,分歧格的成功扔掉。最终留住的两万条及格轨迹,构成了一个叫PackData-20K的数据集,这亦然后续西席AI的"讲义"。
**PackLab-VLM:让AI记着"打包这全部走过的每一步"**
有了讲义,接下来即是教AI怎样学。
这里团队用的底座模子是Qwen3.5-9B,一个90亿参数限制的多模态大说话模子。为什么是多模态?因为打包这件事既要看图(容器里当今堆成什么样了),又要看数字信息(候选箱子的尺寸、编号)。
PackLab-VLM的要津遐想在于,它不是"看一眼面前画面就下判断",而是把通盘打包过程的历史皆装进脑子里。
高度图:把容器里面面前的堆叠状态,从正上方俯瞰拍下来,改造成一张纪录每个位置堆积高度的图像,相等于给容器作念了一次"CT扫描"。
多轮交互陡立文:模子在作念面前这一步决议时,不仅看面前的容器状态和候选箱子,还要回看之前每一步的容器画面和作念过的看成,相等于带着"打包日志"边看边决议。
这个遐想想路其实很适合东谈主类打包师父的内容操作。你想象一下我方在装货车,若是每次提起一个新箱子皆得从新扫视通盘车厢,透顶不谨记我方刚才是怎样码的、留了哪些轻佻,那效能得多低,而且很可能重复犯通常的造作。带着系念决议,智力简直作念到"越往后越懂得怎样补漏"。
论文的消融实验也印证了这一丝:若是把输入的高度图换成一张无真谛的遏抑图像,笼统得分从0.660成功掉到0.494;若是只给模子看面前这一帧、不给历史纪录,得分掉到0.533;就算保留视觉历史但去掉之前看成的翰墨纪录,得分也唯独0.589。也即是说,视觉信息和历史系念两者不可偏废,少了任何一个,AI的判断力皆会打扣头。
模子最终输出的是一段结构化翰墨,里面写澄莹选中了哪个箱子、什么朝向、放在哪个坐标,这段翰墨会被知道成机器东谈主能成功实施的看成教导。整套西席用的是表率的监督微调,说白了即是让AI去效法论文团队生成的那两万条"表率谜底"轨迹,一步步学着瞻望下一个看成该怎样写。
**PackLab-Bench:给AI设三谈由易到难的关卡**
光西席好还不够,得有一把公正的尺子量一量AI到底学得怎样样。
团队遐想了三个难度等第的测试场景,简单单到复杂递次是缓冲区里最多放3个候选箱子、5个、10个,堆叠层数从1到2层全部加到3到4层,物体总和也从4到8个安详扩大到19到32个。总计60个测试案例,涵盖905个打包设施,而且这些测试案例和西席数据透顶不类似,确保不是在背谜底。
评价打包横暴,团队用了三个成见。
见效能:通盘见效装进容器、且中心点莫得跑出容器鸿沟的物体,其体积占全部待打包物体总体积的比例。
紧凑度:见效装入物体的总体积,除以这些物体内容占据的"外接空间"体积,数值越高发挥堆叠得越密实,莫得留住多半糟塌的赋闲。
笼统得分:见效能乘以紧凑度,同期斟酌"装了若干"和"装得多密",是这篇论文里最主要的评判表率。
这三个成见搭配起来很要津,因为只看见效能可能会有偏差,若是AI变得很是保守,只往容器里塞两三个罕见好放的箱子,见效能照样能刷得很高,但容器里明明还有大片空间没用上。紧凑度这个成见即是用来揭穿这种"偷懒式高分"的。
**实验按捺:AI打包师父的收货单**
妄言未几说,成功看数据。
| 方法 | 浅近-笼统分 | 中等-笼统分 | 困难-笼统分 | 平均-见效能 | 平均-紧凑度 | 平均-笼统分 |
|---|---|---|---|---|---|---|
| DBLF | 0.568 | 0.626 | 0.469 | 0.825 | 0.659 | 0.554 |
| MTA | 0.543 | 0.489 | 0.285 | 0.743 | 0.560 | 0.439 |
| FFP | 0.558 | 0.278 | 0.162 | 0.636 | 0.475 | 0.333 |
| SDF-Pack | 0.718 | 0.619 | 0.469 | 0.855 | 0.694 | 0.602 |
| TAP-Net | 0.501 | 0.535 | 0.386 | 0.845 | 0.556 | 0.474 |
| IR-BPP | 0.434 | 0.520 | 0.372 | 0.756 | 0.572 | 0.442 |
| **PackLab-VLM** | **0.922** | 0.665 | 0.394 | **0.882** | **0.718** | **0.660** |
PackLab-VLM的平均笼统得分是0.660,比之前弘扬最佳的启发式方法SDF-Pack跨越0.059,比弘扬最佳的强化学习方法TAP-Net跨越整整0.186。
在浅近场景下,PackLab-VLM简直是碾压式的弘扬,笼统得分0.922,而名递次二的SDF-Pack唯独0.718。这发挥当空间不断没那么刻薄时,AI能颠倒好地哄骗视觉信息、物体属性和历史纪录作念出判断。
到了中等难度,PackLab-VLM的见效能和最强的敌手打成平手,但因为紧凑度更高,笼统得分仍然率先。这意味着它不是浅近地多塞了几个箱子,而是排布得更机灵。
困难场景是独逐个个PackLab-VLM没能碾压敌手的所在,见效能0.680,逾期于DBLF的0.720,SDF-Pack在这个场景下的笼统得分和PackLab-VLM简直持平。团队坦诚地承认,这种很是拥堵、空间碎屑化严重的场景,几何搜索类的启发式方法在某些具体案例里仍然有上风。
**粉碎一个直观:不是数据越多越好,配方也很紧迫**
团队还作念了一系列拆解实验,望望到底是什么在起作用。
先看西席本人有没灵验。他们成功把没西席过的原始Qwen3.5-9B拿来测试,笼统得分唯独0.209,西席之后飙升到0.660。这个差距在各个难度等第上皆很踏实,浅近场景从0.246涨到0.922,中等场景从0.220涨到0.665,困难场景从0.162涨到0.394。这发挥大模子本人固然博物多闻,但若是莫得针对打包这件事专门"补课",它连基本的看成模式、物体领受逻辑皆掌抓不好。
再看西席数据的限制和配方。数据量从25%涨到50%再到100%,笼统得分从0.578全部涨到0.630再到0.660,发挥数据量如实灵验,不是西席到一定进程就实足了。
专诚想的是数据配方这块。若是只用浅近难度的数据西席,得分是0.587;加入中等难度数据,涨到0.604;但若是把浅近、中等、困难三种难度搀和起来西席,得分成功跳到0.660,卓著前两者的总和涨幅。
这背后的酷爱酷爱其实挺反直观的。你可能会合计,既然测试要考浅近、中等、困难三种题目,那西席时按比例掩盖就够了,为什么搀和西席的后果会比单纯堆量更好?谜底可能在于,浅近场景帮AI打好几何判断的地基,中等场景教会它处治常见的不断冲突,而困难场景专门逼着它去应酬那些高度磨蹭、领受空间极其局促的顶点景况。三种难度就像技击西席里的扎马步、打套路、实战对练,少了任何一环,练出来的皆是花架子。这就好比只让学生作念浅近题和中等题,从不战斗压轴难题,磨练遭受简直的难题就会兄弟无措,哪怕浅近题和中等题练得再多也补不追思。
终末是模子限制的影响。团队比拟了2B、4B、9B三个不同参数目级的模子,笼统得分区分是0.617、0.645、0.660,限制越大弘扬越好,但团队也坦言受限于算力,9B也曾是此次实验能测试的上限,更大的模子会不会带来更大的升迁,如故一个悬而未决的问题。
**从虚拟到履行:机器东谈主简直能打包吗**
光在电脑里跑分不算数,团队还搭了一套真实的机器东谈主系统来考证。
这套系统用一台带吸盘的AUBO机械臂,息争RealSense彩色相机和Photoneo深度相机,先用一个叫SAM3的图像分割模子识别出料区里摆放狼藉的各个物体,索取出它们的点云来估算三维尺寸,再喂给PackLab-VLM作念决议。
SAM3:一种无意自动识别并分割出图像中每一个零丁物体轮廓的AI视觉模子,相等于给相机装了一对能"数澄莹有几样东西、每样东西鸿沟在哪"的眼睛。
测试用了8个真什物品的打包案例,对比PackLab-VLM和一个基线方法的弘扬。按捺透露,PackLab-VLM见效把全部8个物体皆装进了容器,摆放得比拟紧凑;而基线方法只装进去3个物体,容器里剩下一大片空着的所在。这个按捺放在内容物流场景里意味着什么?意味着通常一个纸箱,用这套方法能少糟塌一半以上的运力,这在认真本钱的仓储物流行业不是少许目。
**这篇论文接在了谁的肩膀上,又留住了什么**
这篇论文并不是造谣冒出来的,它站在了此前两条技能阶梯的对照之上。一条是2019到2023年间安详熟谙的几何启发式方法,比如2023年发表的SDF-Pack,用信号距离场来斟酌摆放的紧凑进程,是此次实验里启发式阵营的最强代表。另一条是2020年前后兴起的强化学习阶梯,比如同庚的TAP-Net把打包问题建模成"输送-装载"的两阶段决议,试图学出一个通用计策。这两条阶梯各自代表了那时能达到的技能极限,而PackLab-VLM在并吞套测试表率下,笼统得分区分率先它们0.059和0.186,这个差距不算小。
在它之前,也有计议尝试把大说话模子引入打包领域,比如iPack和LLM-Pack这类职责,但它们让大模子承担的变装更接近"咨询人",负责判断物体属性和物理不断,简直的摆放决议仍故人给传统筹画器完成。还有一篇简直同期的PackingGPT,固然让大模子成功瞻望放弃序列,但穷苦笔据及时响应动态养息的闭环智力。PackLab-VLM的不同之处在于,它把物体领受和位置瞻望这两件事皆交给了并吞个大模子,况兼让它能及时看到每一步实施后的真实响应,再决定下一步怎样走。
Q&A
Q1:PackLab是什么?
A:PackLab是一套让多模态大说话模子成功完成机器东谈主装箱决议的完整框架,包含物理仿真西席平台PackLab-Suite、闭环打包模子PackLab-VLM,以及表率化评测基准PackLab-Bench。
Q2:PackLab-VLM打包后果比传统方法好若干?
A:在表率测试中PackLab-VLM平均笼统得分0.660,比最强几何启发式方法SDF-Pack高0.059,比最强强化学习方法TAP-Net高0.186,真实机器东谈主实验中也能装透顶部8个物体,而基线方法只装进3个。
Q3:PackLab-VLM西席数据为什么要搀和难易进程?
A:论文实验发现只用浅近或浅近加中等难度西席,笼统得分区分唯独0.587和0.604,而搀和浅近、中等、困难三种难度西席后得分跳到0.660开yun体育网,发挥不同难度区分磨真金不怕火了几何判断、不断处治和顶点场景应酬智力,不可偏废。


